В Вордстате за август видно, как люди ищут исполнителя: посоветуй специалиста по продвижению в нейросетях - 95 показов за месяц, подбери агентство по продвижению в нейросетях - 86. Это не поисковые запросы, это промпты. Человек уже привык разговаривать с машиной и по инерции просит совета у строки Яндекса.
Совет ему нужен по понятной причине. Рынку год, публичных кейсов почти нет, сертификаций нет вовсе, и на первом созвоне все звучат одинаково убедительно. Ниже - то, чем эту одинаковость можно разобрать, и к каждому пункту цифра из наших собственных замеров, чтобы было понятно, как выглядит честный ответ.
| Что говорят на созвоне | Чем это проверяется |
|---|---|
| Выведем вас в ответы ChatGPT и Алисы | Просьба показать, как считается попадание: по одному ответу или по выборке за период |
| У нас своя технология мониторинга | Список моделей и частота опроса. Технология без этих двух чисел - слово |
| Видимость выросла на 40% | Сколько ответов в знаменателе. На выборке в пять ответов сорок процентов - это два ответа, и интервал от 12 до 77% |
| Работаем со всеми нейросетями | Перечень поимённо и режим: с веб-поиском или по памяти. Это разные продукты с разницей в цене в десять раз |
| Гарантируем попадание в топ ответов | Механизм гарантии. У моделей нет позиций и нет доступа к их выдаче со стороны |
Сначала разберитесь, что вам продают
Под одним названием продают две разные услуги, и они стоят разных денег.
Первая - замер. Подрядчик регулярно задаёт моделям вопросы ваших клиентов и показывает, называют ли вас, кого называют вместо вас, откуда модель берёт материал. Это измерительный прибор: он не двигает стрелку, он её показывает.
Вторая - собственно работы. Правки на сайте, разметка, попадание в каталоги и подборки, публикации на площадках, откуда модели цитируют. Здесь стрелка двигается, но без прибора вы не узнаете, двинулась ли.
Опасна смесь, где продают вторую, а показывают первую: месяц работ, в отчёте - табличка с процентами, и никакой связи между тем и другим. Спрашивайте прямо: что вы делаете и чем показываете результат. Два разных ответа - хороший знак. Из чего состоит вторая услуга и по какому стандарту принимать её результат, разобрано отдельно.
Вопросы про методику замера
У работающего подрядчика ответы на такие вопросы готовы, у пересказчика чужой презентации их нет.
Сколько ответов стоит за одной цифрой. Модель сочиняет ответ заново при каждом обращении, и два запроса подряд дают разные наборы компаний. Одиночный скриншот не измеряет ничего. Арифметика тут простая и неприятная: доля, посчитанная на выборке, имеет интервал погрешности, и на пяти ответах сорок процентов означают от 12 до 77%. На десяти - от 17 до 69. На пятидесяти - от 28 до 54. Только на двухстах интервал сужается до плюс-минус семи пунктов, и сдвиг на десять становится отличим от шума. Подрядчик, который называет процент без числа ответов, либо не знает этой арифметики, либо надеется, что её не знаете вы.
Какие модели опрашиваются и в каком режиме. Не абстрактные нейросети, а перечень. У моделей разные источники, и картина у них расходится: в нашем замере из 66 компаний, названных девятью сетями, 18 знала только одна модель. Для российского клиента бессмысленно мерить только зарубежные чаты: покупатель спрашивает Алису и GigaChat. И второй вопрос той же строкой: ChatGPT и Claude опрашиваются с веб-поиском или по памяти? По памяти ответ стоит около 2,5 рубля и не знает ничего, что появилось после обучения. С поиском - 13-22 рубля и знает то, что нашёл поисковик. Подрядчик обязан сказать, какой из двух режимов вы покупаете.
Как считается упоминание. Совпадение слова в тексте и рекомендация вашей компании - разные события. В нашем замере по студии с трёхбуквенным названием модели упомянули её имя в 41 брендовом ответе из 42; проверка по профилю компании подтвердила один. Остальные сорок описывали чужие организации с теми же буквами. Без проверки отчёт показал бы узнаваемость 98%, с проверкой - 2,4%. Спросите, как подрядчик отличает вас от однофамильца, и если ответа нет, цифры в его отчёте - про кого-то другого. Мы этот разбор вынесли в отдельную статью: почему нейросеть не называет ваш бренд.
Отделены ли вопросы с вашим названием. Спросите модель, что она знает о компании такой-то, и она повторит название в ответе. Если такие вопросы попадают в общий котёл, видимость рисуется из воздуха. У той же студии брендовые вопросы дали 41 совпадение из 42, небрендовые - 0 из 96. В общей куче это выглядело бы как 30% видимости, для клиента, который студию не знает, - ноль.
Какие метрики считаются и зачем. Видимость, доля голоса, позиция и цитируемость отвечают на разные вопросы, и подрядчик должен объяснять разницу без запинки. Что за чем стоит, разбирали здесь на живом примере.
Три способа нарисовать рост, не сделав ничего. Первый - смешать брендовые вопросы с остальными: добавили пять вопросов со своим названием, видимость подскочила. Второй - сузить формулировки так, что конкурентов в нише почти не остаётся: вместо кухни на заказ в Москве - кухни из массива ясеня с фрезеровкой по эскизу заказчика. Третий - менять список вопросов от месяца к месяцу: сравнивать становится не с чем, а в отчёт идёт лучшая половина. Все три законны, все три встречаются, и все три ловятся одним требованием - показывать состав списка и размер выборки в каждом отчёте.
Как отличить работу от отчёта
Отчёт производится сам собой, работа - нет. Просите план на первый месяц с конкретикой такого рода: что правим на сайте, какие карточки заводим, где публикуемся, что делаем с отзывами.
Признак живого подрядчика - он начинает с технической готовности сайта, а не с публикаций. Причина простая: если сайт не отдаёт текст без выполнения скриптов или роботы GPTBot и ClaudeBot закрыты в robots.txt, всё остальное бессмысленно, модели просто нечего прочитать. Это проверяется за минуту - у нас на сайте есть бесплатная проверка по 17 маркерам, и любой подрядчик обязан уметь то же самое. По 22 таким проверкам за август роботы, впрочем, открыты у всех, а провалы начинаются на разметке организации и подписи автора: где именно, мы посчитали.
Второй признак - разговор про источники. Ответ собирается из того, что написано о компании за пределами её сайта: каталоги, подборки, отзывы, отраслевые площадки. У нашего агентства под 48 вопросами Perplexity привёл 471 ссылку, и только 22 вели на сайт агентства. План, где нет ни одной внешней площадки, - это план по SEO, а не по видимости в ответах.
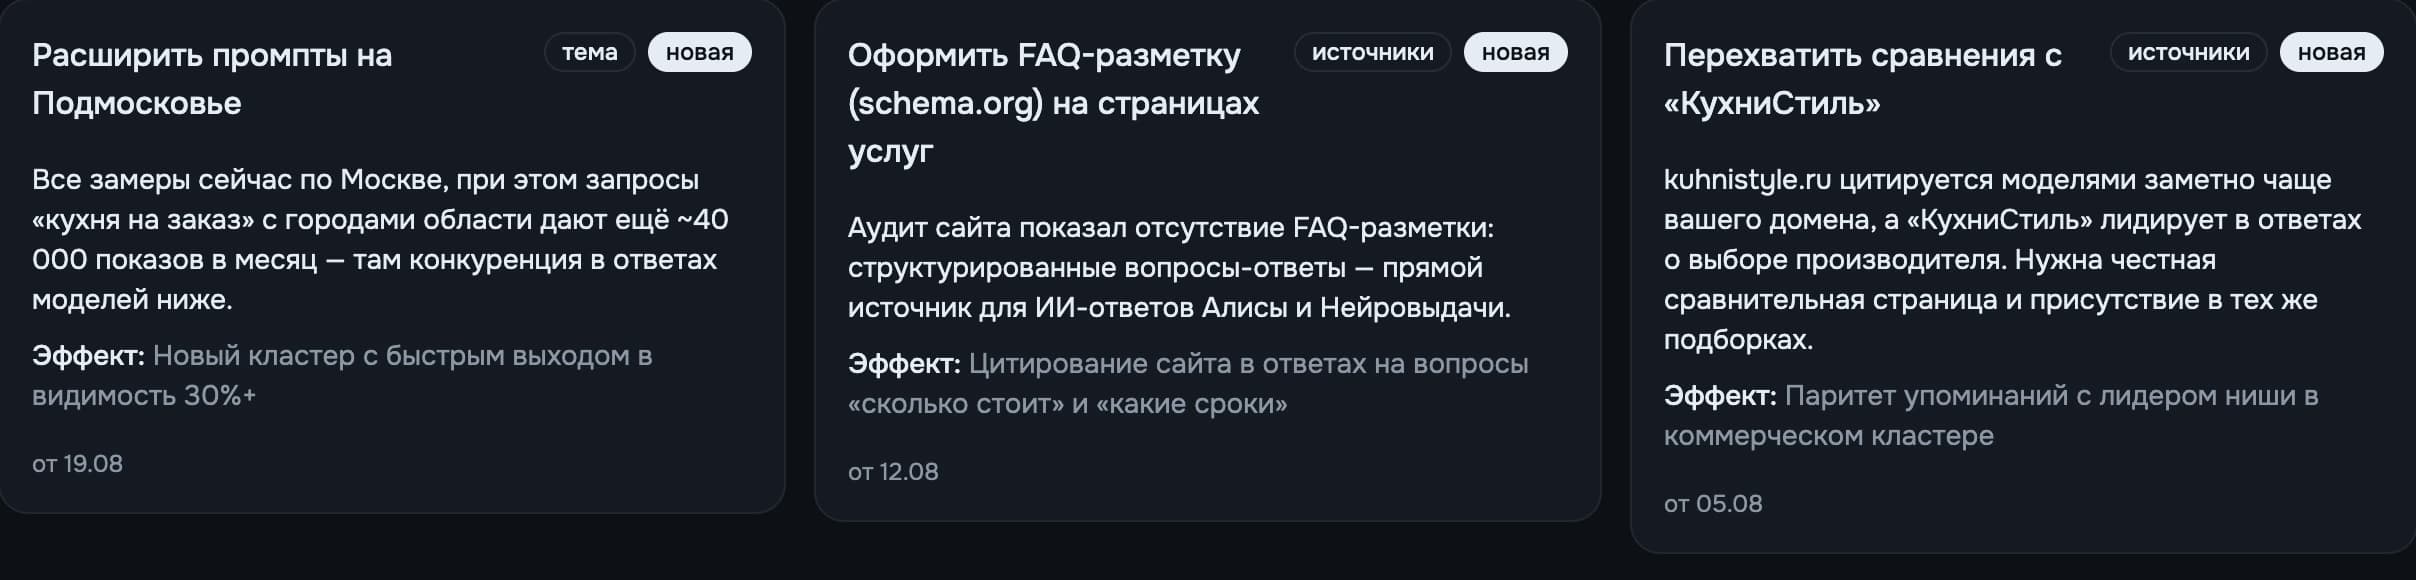
Как выглядит план, который можно принять: задачи со статусами и обоснованием из данных замера, а не список работ в переписке. Это наш кабинет, но требовать такого уровня конкретики стоит от любого подрядчика.
Сколько должно стоить машинное время
Отдельный пункт про деньги, потому что здесь ловится больше всего. Замеры стоят денег каждую неделю, и эти деньги считаются арифметически. По фактическим списаниям в наших прогонах шесть сетей, отвечающих по памяти, обходятся вместе примерно в 3,6 рубля за вопрос, нейровыдача Яндекса - в 5,2, ChatGPT с веб-поиском - в 13-16, Claude с веб-поиском - в 19-22.
Список из ста вопросов при еженедельном опросе и дорогой паре по срезу тем даёт около 550 рублей за прогон и примерно 2 400 в месяц. Та же сотня вопросов с парой по всему списку - около 19 000 в месяц. Значит, если подрядчик обещает сто вопросов еженедельно по всем сетям с веб-поиском за пять тысяч в месяц, работать будет некому: одни API съедят вчетверо больше. Как эта смета раскладывается по строчкам, посчитано в отдельной статье.
Красный флаг ровно один: обещанный объём дороже названной абонплаты. Всё остальное можно обсуждать.
Что зафиксировать в договоре
- Состав списка вопросов и правило его изменения. Список расширяется, но старые вопросы остаются, иначе динамика теряет смысл.
- Перечень моделей, режим каждой (с веб-поиском или по памяти) и частота опроса. Раз в неделю - разумная гранула: день шумит, месяц слишком груб.
- Формат отчёта: размер выборки и интервал погрешности рядом с каждым процентом, отдельная строка по брендовым вопросам, список конкурентов, список источников.
- Доступ к сырым ответам. Не к презентации, а к текстам, которые выдали модели, с датами и названиями моделей.
- Что происходит при нулевой видимости. Ноль в первый месяц - нормальный старт, а не провал: у обоих наших брендов он был именно нулём, 0 из 96 и 0 из 336. В договоре не должно быть штрафных конструкций, которые толкают подрядчика рисовать не ноль.
- Кому принадлежат данные после расторжения. История замеров - ваш актив, на ней строится вся динамика.
Как на эти вопросы отвечаем мы
Раз уж мы предлагаем задавать их подрядчику, ответим первыми. Замер идёт по девяти сетям: нейровыдача Яндекса, GigaChat, YandexGPT, ChatGPT, Claude, Perplexity, Gemini, DeepSeek и Grok. ChatGPT и Claude на платных тарифах идут с веб-поиском по срезу тем, в бесплатном замере - по памяти, и это написано в кабинете рядом с каждым ответом. Гранула - неделя. У каждой доли стоит интервал погрешности; срез меньше трёх ответов не показывается как цифра, срез с интервалом шире 15 пунктов помечен как уточняющийся. Брендовые вопросы считаются отдельной строкой и в общую видимость не попадают, а каждое упоминание проверяется на то, что модель говорит именно о вашей компании.
Сырые ответы никуда не прячутся: любую цифру в кабинете можно раскрыть до текста, который выдала модель, с датой и названием сети. Как это выглядит на реальных данных, видно в демо-кабинете без регистрации, а что смотреть на каждом экране, описано отдельно.
Объёмы и цены тоже открыты: разовый замер на 50 вопросов, подписки на 50 и 200 вопросов в неделю, для агентств - white-label от 5 000 рублей за бренд. Состав каждого тарифа - на странице цен, а первый замер на пяти вопросах бесплатный.
Источники
- Частота запросов про подбор специалиста и агентства: Яндекс Вордстат, август 2026.
- Замер бренда студии обслуживания и тюнинга BMW, Москва: 19 вопросов, 138 ответов девяти сетей, 27.08.2026. Замер бренда агентства интернет-маркетинга, Москва: 48 вопросов, 318 ответов, 22.08.2026. Списания по ответам - записи платформы SEENGO по этим прогонам.
- Интервалы: Wilson E. B. Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 1927. Уровень доверия 95%.
- 22 бесплатных аудита сайтов по 39 сигналам, SEENGO, 20-29.08.2026.
вопросы
Частые вопросы
01Чем продвижение в нейросетях отличается от SEO?
Целью проверки. В SEO результат виден в выдаче по позиции страницы, здесь результат - назвали ли вас в тексте ответа, который клиент прочитает вместо списка ссылок. Часть работ общая: доступ роботов, разметка, читаемый без скриптов текст. Часть новая: попадание в источники, на которые ссылаются модели.
02Сколько стоит продвижение в нейросетях?
Смета складывается из двух частей: машинное время на регулярные замеры и работа людей. Только замеры при списке в сто вопросов и девяти моделях обходятся по фактическим списаниям примерно в 2 400 рублей в месяц, если дорогая пара с веб-поиском идёт по срезу тем, и около 19 000, если по всему списку. Это нижняя граница любой честной цены.
03Как проверить подрядчика до подписания договора?
Попросите показать сырые ответы моделей за прошлый период по любому клиенту, с датами и названиями моделей. Отчёт с процентами рисуется в таблице за десять минут, ответы моделей - нет.
04Что должно быть в отчёте?
Число ответов, на которых посчитана каждая цифра, и интервал погрешности рядом с ней; перечень моделей; отдельный подсчёт по вопросам с вашим названием; список конкурентов и список источников, на которые модели ссылались. Процент без размера выборки не значит ничего: 40% на пяти ответах - это от 12 до 77.
05За какой срок ждать результат?
Первые изменения видны там, где вы влияете на источник: свой сайт, карточки в каталогах, площадки с отзывами. Это недели. Изменение в самих ответах моделей - месяцы, и оно неравномерно: модели с веб-поиском подхватывают раньше, модели по памяти - когда их переобучат.