GEO-оптимизация сайта - это шесть групп работ на самом сайте, после которых нейросети могут его прочитать, понять, о какой компании речь, и вынуть из страниц готовый ответ. Доступ роботов, текст без скриптов, разметка организации и вопросов-ответов, структура страниц под извлечение, машиночитаемые даты и метатеги внутренних страниц. Всё остальное, от отзывов на площадках до замера, относится уже к продвижению, а не к оптимизации.
Запрос "geo оптимизация" задают в Вордстате около 860 раз в месяц, за год частота выросла почти вчетверо. Хвосты "заказать", "агентство", "услуги" говорят, что читатель уже собрался платить. Поэтому ниже не рассуждение о термине, а состав работ в том виде, в каком его можно вставить в техническое задание: с порогами, по которым каждый пункт принимается или нет.
Где кончается оптимизация и начинается продвижение
Слова "GEO-оптимизация" и "GEO-продвижение" в коммерческих предложениях гуляют как синонимы, и это создаёт проблему при приёмке. Оптимизация - то, что можно проверить, глядя на сайт. Продвижение - то, что можно проверить, только спросив нейросети. Если в договоре написано "оптимизация", а ожидание - "нас начнут называть", спор неизбежен.
Мы разводим их так. Оптимизация решает задачу "модель способна меня прочитать и понять". Продвижение - на вопрос "называет ли она меня, когда клиент спрашивает". Первое - условие второго, но не гарантия: в нашем замере студии обслуживания BMW сайт был технически в порядке, а в 96 ответах на вопросы без её названия студию не назвал никто. Модели брали материал с площадок, где о ней не писали.
Эта статья - про первое. Про план на девяносто дней, куда входят площадки и замер, у нас есть отдельный разбор.
Пункт 1. Роботы моделей допущены поимённо
Первый пункт ТЗ звучит скучно и стоит дороже всех остальных, потому что его провал обнуляет всё. Сайт должен пускать роботов не только Яндекса и Google, но и самих моделей, и у каждой они свои: у OpenAI три разных, для обучения, для поискового индекса и для заходов по запросу пользователя; у Anthropic и Perplexity - тоже по нескольку, у Google для Gemini - отдельный Google-Extended. Запрет для любого из них может стоять в robots.txt со времён редизайна, когда от ИИ решили закрыться на всякий случай.
Порог приёмки: в robots.txt нет запрета для перечисленных роботов, сайт не закрыт целиком, на важных страницах нет noindex ни в метатеге, ни в заголовке ответа сервера. Отдельно проверяется, что несуществующий адрес отдаёт 404, а не 200: мягкие 404 засоряют индекс дублями, и модель получает в выдаче мусорные страницы вместо нужной. И что тег canonical на каждой странице указывает на неё же, а не на другой сайт или старый домен.
Сюда же - защита от ботов на уровне хостинга или CDN. Она режет роботов молча, и в robots.txt этого не видно. Единственная честная проверка - запросить страницу под именем робота модели и посмотреть, что вернётся. Мы делаем это в аудите отдельным полем, а как проверить самому и по логам - в разборе доступа роботов и логов.
Пункт 2. Текст читается без выполнения скриптов
Человек открывает страницу и видит текст. Робот получает то, что отдал сервер, и если текст дорисовывается в браузере скриптом, робот видит пустой каркас с меню. Это самая частая находка в аудитах, и она характерна для сайтов на конструкторах и одностраничных приложений.
Порог приёмки: в HTML, который отдаёт сервер без выполнения скриптов, на странице не меньше 1 500 символов содержательного текста. Меню, шапка и подвал в счёт не идут - иначе одноэкранный сайт с большим меню проходит проверку, а читать в нём нечего. Отдельная строка в ТЗ: сервер отвечает не дольше секунды, по медиане трёх последовательных запросов, а не по единственной удачной пробе.
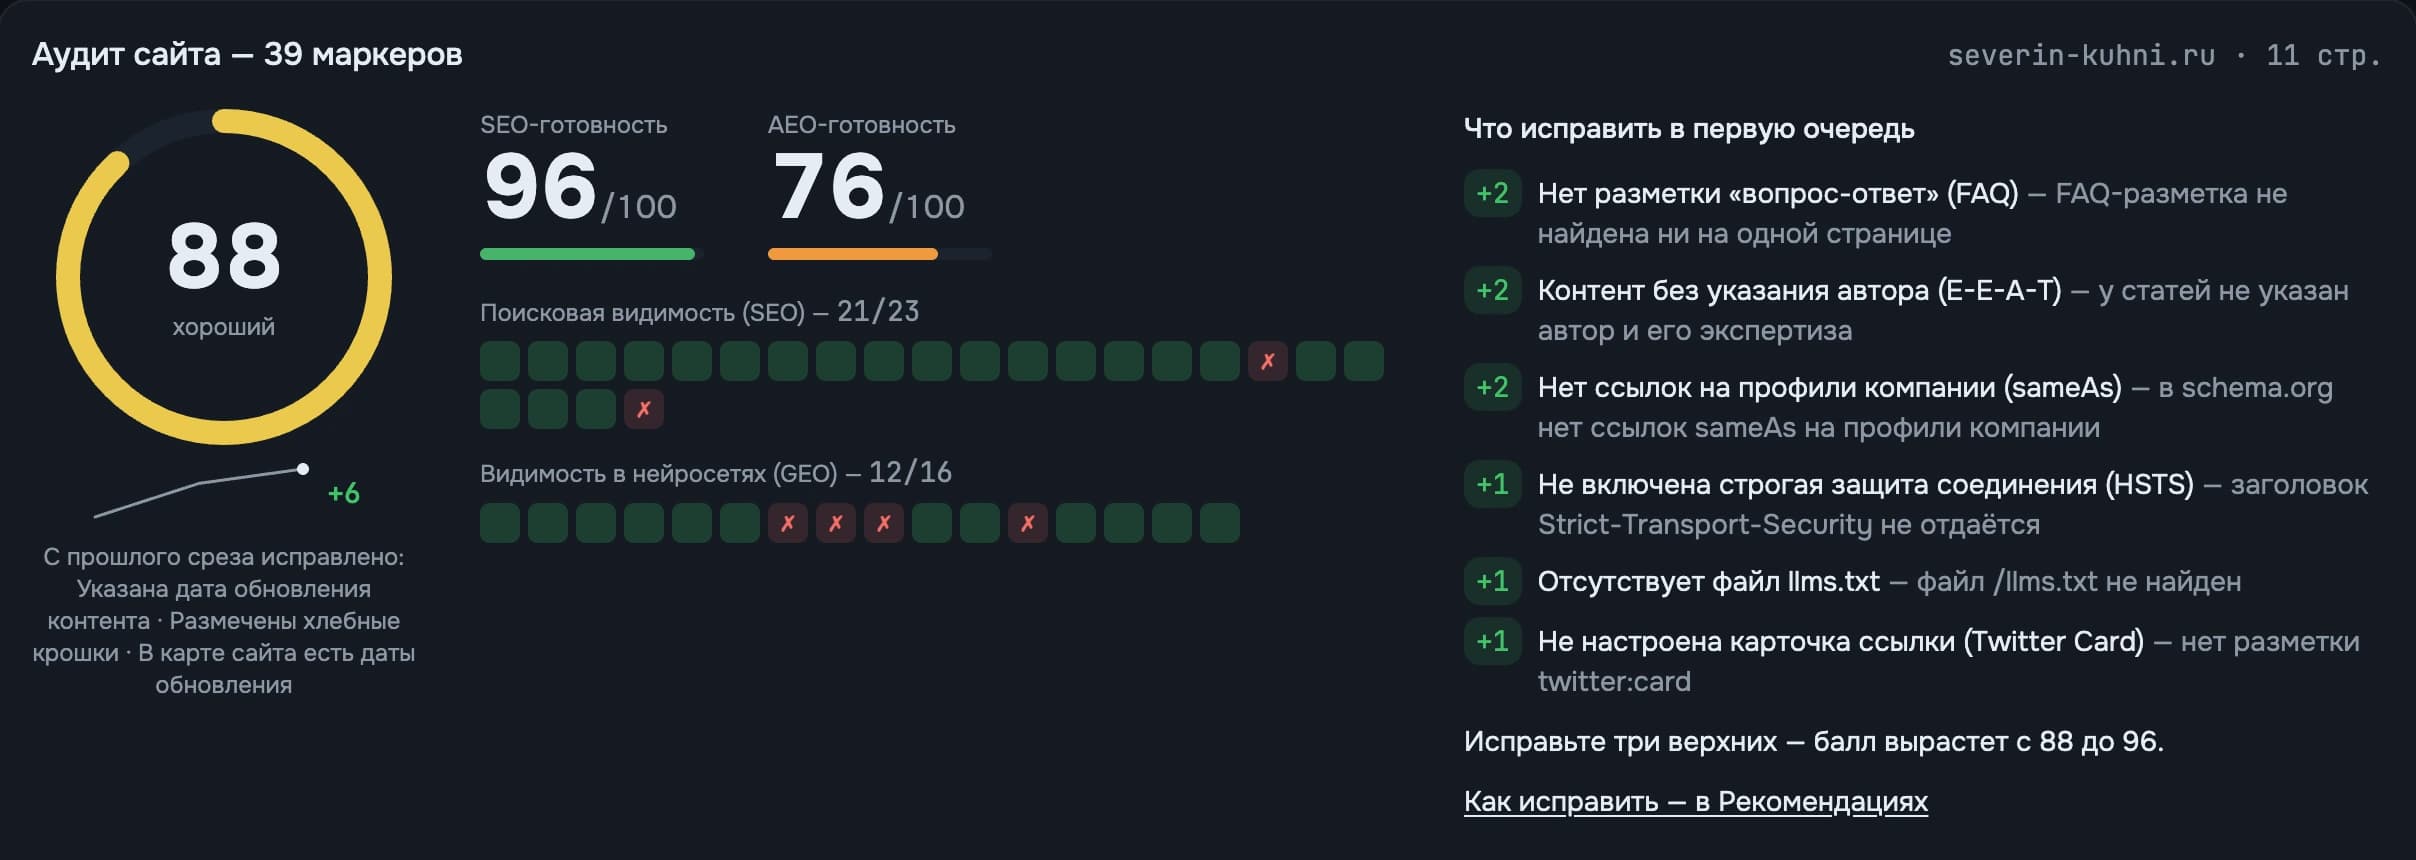
Аудит в кабинете показывает оба пункта выше в цифрах: сколько символов контента отдаётся без скриптов и за сколько секунд отвечает сервер. Каждый провал подписан тем, что именно найдено, чтобы задача разработчику ставилась без перевода.
Пункт 3. Разметка, из которой можно вынуть факты
Разметка Schema.org - единственный способ сообщить модели факты о компании так, чтобы их не пришлось угадывать по тексту. В ТЗ она распадается на четыре подпункта, и у каждого свой порог.
Тип организации указан: Organization, LocalBusiness, Store или другой подходящий, а не только WebSite и BreadcrumbList. Карточка организации заполнена: название, адрес, телефон, url совпадает с доменом сайта. Полупустой узел, у которого есть только имя, на проверке считается неполным. Есть разметка вопросов и ответов, FAQPage или QAPage, на страницах, где есть что спросить. Есть ссылки sameAs на профили компании: карточка в Яндекс Бизнесе, отраслевые каталоги, соцсети. По ним модель связывает упоминания на площадках с вашим сайтом, и без них "ООО Ромашка" в каталоге и romashka.ru для неё - разные сущности.
Минимальный набор без лишнего мы разбирали в статье о разметке под нейросети. В ТЗ достаточно сослаться на неё и на порог: узел организации найден по url домена и заполнен, FAQ размечен, sameAs не пустой.
Пункт 4. Страница построена под извлечение ответа
Модель не читает страницу целиком. Она ищет фрагмент, который можно взять и вставить в ответ: прямое утверждение, список, строку таблицы. Полотно на пять экранов, где ответ на вопрос клиента размазан по абзацам, она пролистает и возьмёт ответ у конкурента, у которого он в первой строке раздела.
Порог приёмки здесь двойной. Формальный: в содержательной части страницы, вне меню и подвала, есть хотя бы один список или таблица и не меньше двух подзаголовков второго-третьего уровня. Содержательный, и его проверяет человек: под каждым подзаголовком первый абзац отвечает на вопрос заголовка, а не подводит к нему. Подзаголовки в форме вопросов - самый простой приём, он же засчитывается как вопросы-ответы даже без разметки.
Порог "один список и два подзаголовка" кажется низким, и он низкий намеренно. Это проверка на грубую ошибку - страница-полотно, а не на качество текста. Качество текста аудит не меряет. Его меряет замер: попала ли страница в ответ. Что из текста модели забирают в ответ, а что пропускают, разобрано отдельно.
Пункт 5. Даты, по которым видно, что сайт живой
Модели, которые ищут в вебе, предпочитают свежие источники, и свежесть они определяют по машиночитаемой дате, а не по слову "2026" в тексте. Дата берётся из разметки, dateModified или datePublished, из метатега article:modified_time или из заголовка Last-Modified.
Порог приёмки: дата читается и не старше полутора лет. Само наличие поля не засчитывается - на проверке встречались сайты с датой пятилетней давности в разметке, и формально поле у них было. В ТЗ стоит добавить процесс: дата обновляется при реальной правке страницы, а не проставляется скриптом на текущий день при каждой загрузке. Второе модели рано или поздно распознают как подделку, и доверие к остальным датам на сайте падает.
Пункт 6. Внутренние страницы, а не только главная
Половина сайтов проходит проверку главной и проваливает всё остальное. У страниц услуг нет собственного title и description, дублируется заголовок с главной, разметка стоит только на первой странице. Модель, которая пришла по запросу про конкретную услугу, попадает на страницу без описания и без карточки - и ей нечего цитировать.
Порог приёмки: у каждой страницы из выборки, в аудите это главная плюс четыре из карты сайта, есть свой title и description, карта сайта находится по стандартному адресу или через robots.txt. Файл llms.txt можно включить в этот же пункт, но не переоценивать: вес у него в нашей методике 5 из 114, и делается он за час.
Как проверить результат без слов подрядчика
Отчёт "работы выполнены" принимать нельзя, потому что каждый из шести пунктов выше проверяется извне, и это занимает меньше времени, чем чтение отчёта. Три проверки.
Первая: аудит одним и тем же инструментом до начала работ и после релиза. Балл сам по себе мало значит, важно, какие пункты перешли из провала в норму. У нас аудит по 17 маркерам открыт бесплатно и без регистрации, сравнение двух прогонов делается вручную за пять минут.
Вторая: логи сервера за две недели после релиза. В них должны появиться заходы роботов моделей под их именами - если их нет, пункт 1 не выполнен, что бы ни было написано в robots.txt. Что искать в логах и как выглядит нормальная картина, показано на недельном логе одного сайта.
Третья, самая важная: замер по одному и тому же списку вопросов до и после. Только он показывает, изменилось ли что-то в ответах, а не в коде. Здесь есть оговорка, которую подрядчики не любят: оптимизация сайта сама по себе может не сдвинуть долю ответов с упоминанием, если модели берут материал с площадок. Тогда замер покажет ноль до и ноль после, и это честный результат - он означает, что следующий этап не на сайте.
Где в этом участвуем мы
Мы делаем измерительную часть: аудит по 17 маркерам с порогами, описанными выше, и еженедельный замер ответов девяти сетей по вопросам вашей ниши. Правки на сайте делаете вы или ваш разработчик - список задач в кабинете формулируется так, чтобы его можно было передать без перевода. Посмотреть, как выглядит аудит и план работ на реальном бренде, можно в демо-кабинете, первый аудит и замер - бесплатно.
вопросы
Частые вопросы
01Чем GEO-оптимизация отличается от GEO-продвижения?
Оптимизация - это работы на самом сайте: доступ роботов, текст без скриптов, разметка, структура, даты. Продвижение шире: к сайту добавляются внешние площадки, отзывы и регулярный замер. Оптимизация - первый и обязательный этап продвижения, но одной её для попадания в ответы обычно мало.
02Сколько страниц нужно оптимизировать?
Начинать с тех, что отвечают на вопросы клиента: главная, страницы услуг или категорий, страница о компании. Шаблонные правки - разметка, даты, метатеги - делаются один раз в шаблоне и накрывают весь сайт. Переписывать все страницы подряд не нужно.
03Можно ли сделать GEO-оптимизацию самому?
Техническую часть - да, если есть доступ к коду и шаблонам. Порядок работ на два дня мы описали в отдельной статье. Разметку и структуру страниц тоже можно сделать своими силами; сложнее всего даётся проверка результата, потому что для неё нужен замер по нескольким сетям.
04Нужен ли llms.txt?
Файл не помешает, но вес у него небольшой: в нашей методике 5 баллов из 114. Ни одна крупная модель не подтвердила, что читает его при ответе. Делать его стоит после того, как закрыты доступ роботов, текст без скриптов и разметка.
05Как понять, что подрядчик сделал работу, а не написал отчёт?
Тремя проверками, которые не зависят от его слов: аудит сайта тем же инструментом до и после, логи сервера с заходами роботов моделей и замер доли ответов с упоминанием по одному и тому же списку вопросов.
06Через сколько GEO-оптимизация даёт результат?
Технические правки видны в аудите сразу после релиза. В ответах сетей, которые ищут в вебе, первые сдвиги в наших замерах появлялись через 2-4 недели. Сети, которые отвечают по памяти, меняют картину не раньше следующего обновления модели, это месяцы.