Вот восемь адресов:
http://example.ru/
https://example.ru/
https://www.example.ru/
https://example.ru/index.php
https://example.ru/index.html
https://example.ru//
https://example.ru/?utm_source=vk
https://example.ru/?yclid=123456
Для владельца сайта это одна главная страница. Для поискового робота - до восьми разных, если каждый адрес отвечает кодом 200 и отдаёт тот же текст. Это и есть дубли страниц: одинаковое содержимое, доступное по нескольким адресам. Убирают их тремя способами: лишние адреса перенаправляют на основной, остальным указывают основной через rel="canonical", а параметры-метки отключают для робота директивой Clean-param.
Мы прогнали эти восемь вариантов по главным страницам 111 сайтов компаний из нашего бесплатного аудита. Обход сделан 4 октября 2026 года.
39 из 111главная по двум и более адресам 30открываются по /index.php или .html 22без тега canonicalЗеркала: с www и без, по http и https
Самый старый вид дублей. Сайт отвечает и на www.example.ru, и на example.ru, и по защищённому протоколу, и по обычному. Правильное поведение одно: три варианта из четырёх отдают редирект с кодом 301 на четвёртый.
У 94 сайтов из 111 так и настроено. У 16 кодом 200 отвечают два варианта и больше, чаще всего это пара "с www и без". Четыре сайта до сих пор открываются по http без перенаправления на https, то есть существуют в защищённой и незащищённой копии одновременно.
Попутно нашлась обратная беда. У девяти сайтов один из вариантов, с www или без, не открывается вообще: запись в DNS не заведена или сертификат выпущен только на одно имя. Дубля тут нет, но человек, набравший адрес "не так", видит ошибку браузера и уходит.
Хвосты index.php и index.html
Главная открывается и по корневому адресу, и по имени файла, который сервер отдаёт по умолчанию. В выборке таких сайтов 30, больше четверти: у 19 отвечает /index.php, у 12 /index.html, у одного оба. Кто-то когда-то поставил ссылку на логотипе на /index.php, робот по ней прошёл, и в базе появился второй адрес главной.
У 13 из этих 30 сайтов canonical не стоит. Поисковик выбирает главный адрес сам, и не всегда тот, что без хвоста.
Про двойной слеш. Адрес https://example.ru// отдаёт главную с кодом 200 у 72 сайтов из 111. Так по умолчанию ведут себя многие серверы, и сам по себе этот вариант редко попадает в поиск: на него никто не ссылается. Но если в шаблоне есть ошибка в сборке ссылок, двойные слеши начинают размножаться по всему сайту.
Метки и параметры
Адрес с рекламной меткой, идентификатором клика или параметром сортировки для робота новый. Таких адресов у одной страницы может быть сколько угодно, и создаёте их не вы, а рекламные системы, рассылки и люди, которые делятся ссылками.
Мы добавили к главной каждого сайта ?utm_source=check. Почти все ответили кодом 200, это нормально: страница обязана открываться с меткой. Вопрос в том, что написано в её canonical. У 87 сайтов там чистый адрес главной, и дубль поисковику не страшен. У 21 сайта canonical нет совсем. Ещё у одного он есть, но собирается из текущего адреса вместе с меткой: такой тег сообщает роботу, что страница с меткой и есть основная.
У нас самих так приходят переходы из Директа: к адресу главной дописывается параметр etext, у каждого перехода свой. Все эти адреса схлопываются в один адрес именно потому, что canonical на главной прописан жёстко, а не вычисляется из запроса.
Слеш на конце, регистр и каталог
Адреса /uslugi и /uslugi/ для робота разные, Яндекс отдельно оговаривает это в своём разборе дублей. То же с регистром: /Catalog/ и /catalog/ - две страницы, если сервер отдаёт обе. Правило одно на весь сайт: выбрали вариант со слешем или без, в нижнем регистре, остальные перенаправили на него. Проверяется так же, как зеркала: набрали адрес в другом написании и посмотрели, изменился ли он в строке браузера.
В интернет-магазинах главный источник дублей - каталог. Одна и та же подборка товаров открывается с сортировкой по цене, по новизне, плиткой и списком, по двадцать и по сорок штук на странице. Каждая комбинация - отдельный адрес с параметрами. Сюда же относятся товары, которые лежат в двух разделах сразу и получают два адреса. Здесь редирект не подходит, все эти страницы нужны покупателю, и работу делают canonical и Clean-param, о которых ниже.
Со страницами пагинации осторожнее. Вторая и третья страницы каталога - не дубли: на них другие товары. Здесь поисковики расходятся. Google просит не указывать на таких страницах canonical на первую, в советах Яндекса встречалась обратная рекомендация. Мы за то, чтобы у каждой страницы пагинации canonical вёл на неё саму: иначе робот может перестать доходить до товаров с дальних страниц.
Несуществующие страницы с кодом 200
Отдельный генератор дублей - сайт, который на любой выдуманный адрес отвечает "всё хорошо" и показывает главную или заглушку. У такого сайта бесконечно много одинаковых страниц. В аудите мы запрашиваем заведомо несуществующий адрес и смотрим на код ответа: из 111 сайтов кодом 200 ответили два. Немного, но для этих двоих цена высокая: робот может обходить мусор вместо каталога.
Чем дубли обходятся
Фильтра за дубли нет, и пугать им не надо. Вред скромнее и неприятнее.
Яндекс в своём блоге для вебмастеров называет две вещи. Первая - "замедление индексирования нужных страниц": робот приходит на сайт с ограниченным запасом обращений и часть тратит на копии. Вторая - путаница в аналитике: поиск сам выбирает, какой адрес показывать, и может его менять. Страница одна, а в отчётах Вебмастера и Метрики её показы и переходы разложены по двум-трём строкам, и ни одна не выглядит успешной.
Третью добавим от себя. Внешние ссылки на страницу тоже делятся между копиями. Один партнёр сослался на адрес с www, другой без, третий на index.php. Для молодого сайта, которому каждая ссылка на вес золота, это потеря на ровном месте.
И четвёртое, про нейросети. Сети с веб-поиском ссылаются на тот адрес, который достался им из поисковой базы. Если в базе лежит копия с меткой или с хвостом, в ответе будет стоять она. Переход по такой ссылке вы получите, но в отчётах он ляжет мимо основной страницы.
Как найти дубли за пять минут
Главную проверяем руками. Четыре команды покажут, как отвечают зеркала:
curl -sI http://example.ru/ | head -1
curl -sI http://www.example.ru/ | head -1
curl -sI https://www.example.ru/ | head -1
curl -sI https://example.ru/index.php | head -1
У основного адреса должен быть код 200, у остальных 301. Если командная строка не ваш инструмент, то же самое видно в браузере: набираете вариант и смотрите, поменялся ли адрес в строке.
Остальной сайт покажет Яндекс Вебмастер. В разделе "Индексирование" откройте "Страницы в поиске" и переключитесь на исключённые. Дубли там помечены отдельным статусом. Список можно выгрузить таблицей. Если дублей с параметрами много, Вебмастер присылает и отдельное уведомление в диагностике.
Что смотреть в выгрузке: какие параметры повторяются, нет ли пар "со слешем и без" и не выбрал ли робот основным не тот адрес, на который вы рассчитывали.
Редирект, canonical или Clean-param
Инструментов три, и у каждого своя работа.
Редирект 301 нужен там, где второй адрес не должен существовать. Зеркала, index.php, слеш на конце, старые адреса после переезда. Посетитель и робот попадают на основной адрес, копия исчезает. Это самый надёжный способ, потому что он не оставляет поисковику выбора.
Canonical нужен там, где адрес обязан открываться. Страница с рекламной меткой, сортировка каталога, версия для печати. В код каждой такой страницы ставится указание на основную:
<link rel="canonical" href="https://example.ru/catalog/" />
На основной странице тег тоже стоит и ссылается на неё саму. Яндекс подчёркивает, что для него это рекомендация: робот "может проигнорировать" указание. Поэтому canonical не замена редиректу, а страховка для случаев, где редирект невозможен.
Clean-param - директива в robots.txt, которую понимает только Яндекс. Она перечисляет параметры, не влияющие на содержимое:
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign&yclid&etext
Робот перестаёт считать адреса с этими параметрами отдельными страницами и не тратит на них обход. Длина одного правила ограничена 500 символами, правил может быть несколько. Google эту директиву не читает, для него остаётся canonical.
Если коротко: зеркала и хвосты закрываем редиректом, параметры в Яндексе закрываем Clean-param, и на всех страницах держим canonical как общую подстраховку.
Пять способов испортить canonical
Сам тег простой, но ошибаются в нём чаще, чем в редиректах. Всё перечисленное мы видели в аудите.
Тега нет. В выборке это 22 сайта из 111, каждый пятый.
Canonical ведёт на другой домен. Три сайта из 111. В двух случаях это сайты на конструкторе, открытые по техническому адресу: основной домен подключён, а техническая копия продолжает отвечать кодом 200 и ссылается на основной через canonical. Логика верная, но Яндекс в справке предупреждает, что не учитывает указание, если в нём "URL в другом домене или поддомене". Здесь нужен редирект, а не тег.
Тегов два. У двух сайтов в коде главной по два тега canonical: обычно один ставит шаблон, второй добавляет плагин. Справка Яндекса на этот счёт однозначна: несколько канонических адресов указывать нельзя.
Canonical собирается из адреса запроса. Тот самый случай с меткой: тег есть на каждой странице и на каждой указывает сам на себя вместе с параметрами.
Canonical указывает на страницу, которая закрыта от индексации или сама перенаправляет дальше. Робот такое указание тоже отбрасывает, как и цепочку из нескольких canonical подряд.
Одну ошибку мы нашли у себя. Аудит сравнивал домен из canonical с доменом, на который пришёл ответ, и у сайтов в зоне .рф считал их разными: в теге стояли русские буквы, а ответ сервера приходил с адресом в виде xn--. Два сайта получили незаслуженный минус. Проверку исправили в тот же день, а подробности - в статье про кириллические домены.
Что из этого видно в аудите
Руками удобно проверять главную. Дальше нужен инструмент, который делает одно и то же на каждой странице.
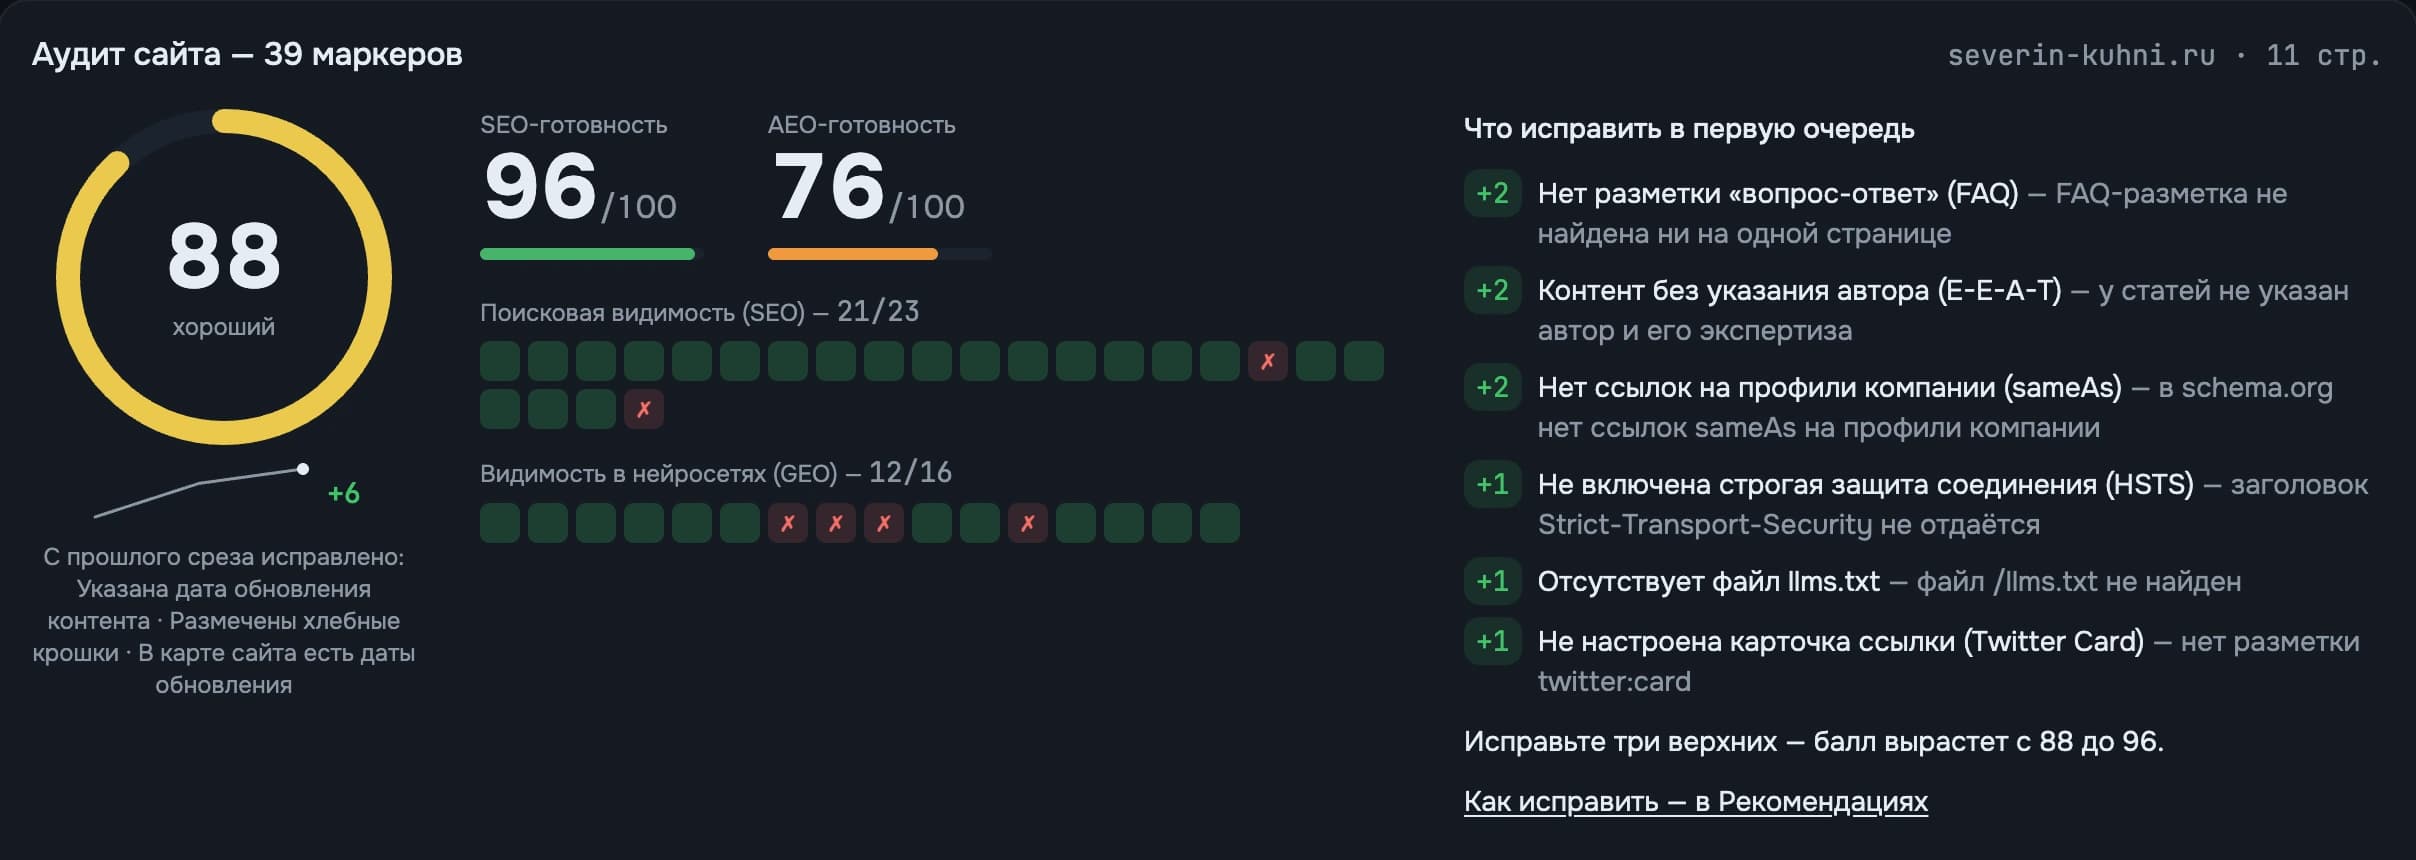
Бесплатный аудит проверяет canonical на главной: есть ли тег, читается ли он и не ведёт ли на чужой сайт. Отдельной строкой идёт ответ на несуществующий адрес. Всего 17 проверок, оценка примерно через минуту, регистрация не нужна.
Чего аудит не делает: он не обходит весь сайт и не строит список дублей по каталогу. Для этого есть отчёт Вебмастера, описанный выше, и это тот случай, когда бесплатного инструмента Яндекса достаточно.
Убрали дубли - отправьте основные адреса на переобход, иначе склейка растянется на недели. Как быстро робот приходит по заявке, мы замеряли в статье про переобход и IndexNow. А если страница должна уйти из поиска совсем, это задача для noindex, а не для canonical.
Что унести с собой
- Проверьте восемь адресов главной из начала статьи. Кодом 200 должен отвечать один.
- Зеркала и index.php закрывайте редиректом 301, canonical здесь слабее.
- Canonical ставьте на все страницы, абсолютным адресом, в пределах своего домена, один на страницу.
- Рекламные метки отключайте для Яндекса через Clean-param.
- После правок смотрите исключённые страницы в Вебмастере: дубли должны уходить, а не прибавляться.
Источники
- Блог Яндекса для вебмастеров: как обнаружить дубли страниц на сайте, 17 января 2022 - виды дублей, вред, отчёт об исключённых страницах.
- Яндекс Вебмастер, справка: канонический адрес страницы - canonical как рекомендация, случаи, когда робот его не учитывает.
- Яндекс Вебмастер, справка: директива Clean-param - синтаксис и ограничения.
- Google Поиск: как указать канонический URL.
- Свои данные: коды ответа восьми вариантов адреса и содержимое canonical у 111 сайтов, снято 04.10.2026. Сами сайты мы не называем.
вопросы
Вопросы про дубли
01Что такое дубли страниц простыми словами?
Это страницы с одинаковым содержимым, которые открываются по разным адресам. Для человека site.ru и www.site.ru/index.php - один сайт. Для робота это два разных адреса, и он сам решает, какой из них показывать в поиске.
02Как проверить сайт на дубли страниц?
Начните с главной: откройте её с http и https, с www и без, с index.php и index.html на конце. Правильно, когда все варианты перенаправляют на один адрес. Дальше посмотрите в Яндекс Вебмастере отчёт Страницы в поиске, вкладку с исключёнными страницами: дубли там помечены отдельным статусом.
03Что лучше от дублей: редирект 301 или rel canonical?
Редирект, если дубль никому не нужен как отдельный адрес: зеркала, index.php, слеш на конце. Canonical, если адрес должен открываться, но в поиске не нужен: сортировки, версии для печати, рекламные метки. Canonical для Яндекса - рекомендация, робот может её не учесть.
04Дубли страниц - это санкции от поисковика?
Нет, фильтра за дубли как такового нет. Вред практический: робот тратит обход на копии, в выдаче оказывается не тот адрес, который вы продвигаете, а статистика одной страницы расползается по нескольким строкам отчёта.
05Нужен ли canonical, если дублей на сайте нет?
Нужен. Дубль с рекламной меткой или параметром появляется без вашего участия: достаточно, чтобы кто-то поделился ссылкой из рассылки. Canonical, указывающий на чистый адрес, закрывает такие случаи заранее.